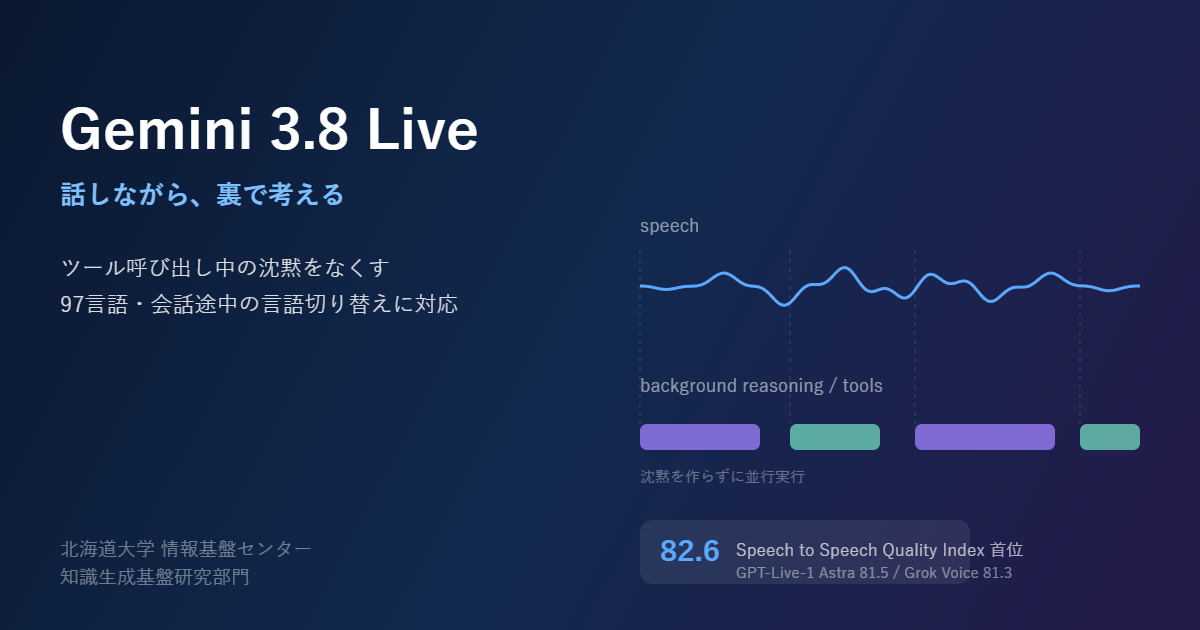
Googleが2026年9月15日、会話用の新モデル「Gemini 3.8 Live」と「Gemini 3.8 Live Extended Thinking」を公開しました。特徴は、喋りながら裏で推論とツール呼び出しを並行させる点です。従来の音声エージェントはツールを呼んでいる間に沈黙が生まれ、それが体感的な遅さの正体になっていました。新モデルは会話のペースを保ったままバックグラウンドでAPI呼び出しを実行し、途中経過を口頭で伝えながら処理を進めます。97言語の音声を理解・生成し、言語の自動判定と会話途中での切り替えにも対応します。Artificial AnalysisのSpeech to Speech Quality Indexでは、Extended Thinkingが82.6で首位に立ち、GPT-Live-1 Astraの81.5、Grok Voice Think Fast 2.0の81.3を上回りました。Big Bench Audioでは97.7%、T-Voiceでは68.6%です。報道によれば標準版の価格は音声入力1分あたり0.005ドル、出力1分あたり0.018ドルで、Extended Thinkingはこれに推論トークンなどが加算されます。提供はGemini API、Google AI Studio、Gemini Enterpriseのプレビュー、およびLiveKitやPipecatなどのパートナー経由です。
音声インターフェースで効くのは、モデルの賢さそのものよりも「間」の設計だ、という主張として読めます。テキストのエージェントであれば数秒の思考時間は許容されますが、対話では1秒の沈黙が破綻として感じられます。推論と発話を分離し、考えている間も喋り続けさせるという構成は、先日紹介したOpenAI Agents APIの文脈自動圧縮やサブエージェントと同じく、モデル本体ではなくその外側で体験を作り込む流れの延長線上にあります。速い標準版と深く考えるExtended Thinkingという二段構えも、用途ごとに価格と品質を選ばせる最近の定石どおりで、音声という遅延に最も厳しい領域でそれが行われた点が目を引きます。