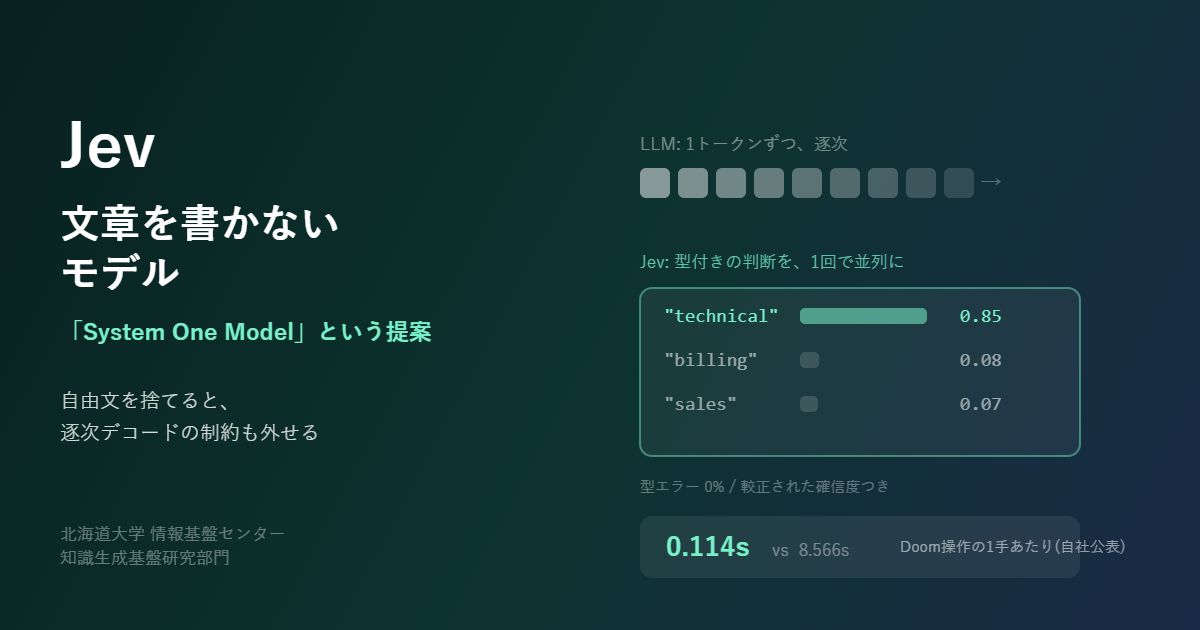
TypeSafe AIが2026年9月15日、2年のステルス期間を経て初のモデル「Jev」を公開しました。最大の特徴は、テキストを生成しないことです。LLMが左から右へ1トークンずつ文章を組み立てるのに対し、Jevは事前に定めた型に沿った判断を一度の問い合わせで並列に出力します。返るのは文章ではなく、たとえば問い合わせのルーティングなら {“billing”:0.08, “technical”:0.85, “sales”:0.07} のような、確率つきの型付き値です。学習にはRLHFでもRLVRでもない「Reinforcement Learning for Calibrated Decisions(RLCD)」を用い、確信度が高いほど実際の正答率も高くなるという較正そのものを目的に最適化しています。スキーマ適合は構造的に保証されるため型エラーは0%で、単段の選択肢は最大255個まで扱えます。自社公表の数値では、応答時間は70ミリ秒〜500ミリ秒(比較対象のLLMは3〜329秒)、入力価格は100万トークンあたり0.042ドルで出力は無料、代表的なワークフローではGPT-6 AstraとFable 5.1の平均に対して193.6倍高速としています。実演としてDoomを操作するボットが公開され、1秒あたり約10回の問い合わせを投げて1時間あたり約7ドル、1回の応答は0.114秒(GPT-5.6 Terraは8.566秒)でした。CEOのDiogo AlmeidaはOpenAIでChatGPTの開発に関わった研究者で、調達額は4,000万ドルです。名称はKahnemanの「システム1」と、効率化がかえって総使用量を増やすジェヴォンズのパラドックスで知られるWilliam Stanley Jevonsに由来します。
当部門で紹介してきたOpenAI Agents APIやSakana AIのFuguは、モデル本体はそのままに、その外側のハーネスやオーケストレーションで性能とコストを改善する方向でした。Jevはこれと逆で、出力形式そのものを作り変えています。分類・ルーティング・スコアリングといった判断に用途を絞れば自由文の生成能力は要らず、そこを捨てると並列サンプリングが可能になって二桁の高速化が効く、という筋です。ハーネス側でどれだけ工夫しても、逐次デコードという土台の制約は外せないわけで、そこに手を入れた点が新しいと言えます。
ただし評価には留保が要ります。「ハルシネーションゼロ」が意味するのはスキーマへの適合であって判断内容の正しさではなく、この点はThe Registerも指摘しています。ベンチマークはすべて自社公表で独立検証はまだなく、TypeSafe自身も、評価ワークフローを自社チームが作成したこと、LLM側を自社のラッパー経由で動かしていること、Wikiracingの実演では見やすさのためLLMを非推論モードで走らせており実力を過小評価していることを但し書きとして明示しています。費用の倍率も公式サイトとブログで244.6倍と444.6倍が食い違っています。自由文もコード文字列も原理的に出力できないため、LLMの代替ではなく、LLMが担っていた定型判断の部分だけを切り出して置き換えるものと捉えるのが正確です。現在はアーリーアクセスの申し込み受付中です。
https://typesafe.ai/blog/introducing-system-one-models-and-jev