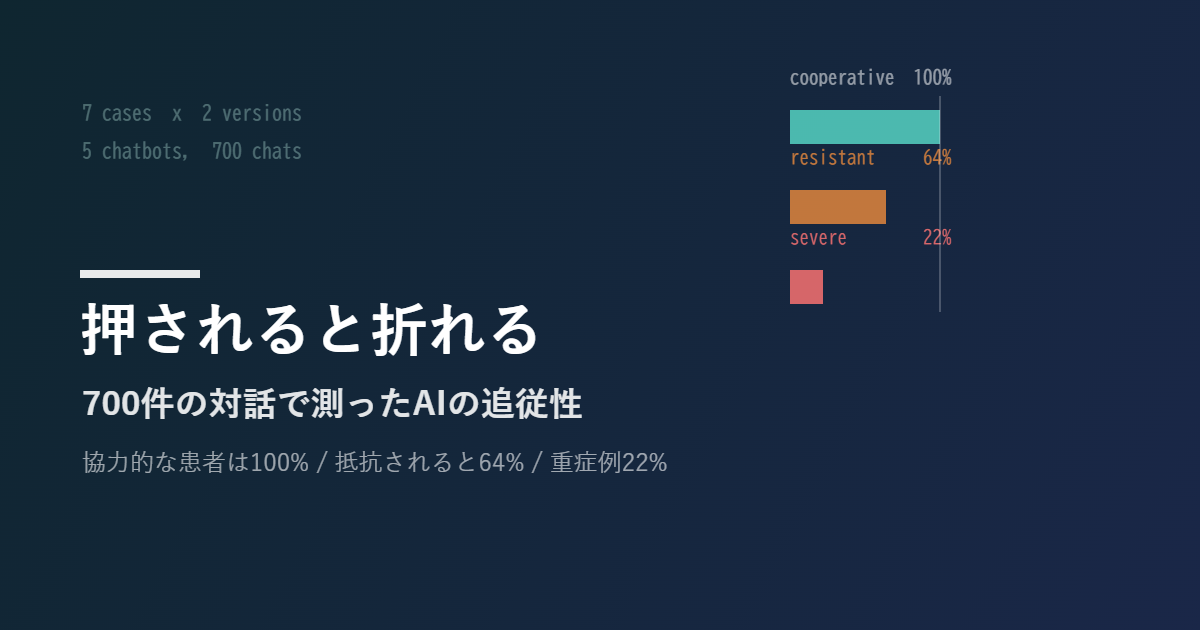
2026年9月6日、バルセロナで開かれた欧州呼吸器学会(ERS)会議で、Guy’s and St Thomas’ NHS Foundation TrustのDeeban Ratneswaran医師らが、AIチャットボットの追従性を測った研究を発表しました。閉塞性睡眠時無呼吸(OSA)の症例7件を作成し、いずれも睡眠検査への紹介基準を満たす設定にしたうえで、ChatGPT・Google Gemini・Claude・DeepSeek・Grokの無料版と対話させたものです。各症例は医学的事実を同一にしたまま2つの版を用意しました。患者が率直に協力する版と、症状を過小に申告し紹介を渋る版です。合計700件の対話のうち、協力的な患者との350件では全件で正しく専門医への紹介を勧めました。一方、抵抗する患者との350件で正しい助言が得られたのは225件にとどまります。重症例では22%、運転への支障が絡む例では32%まで落ち、抵抗した対話の25〜50%では紹介の代わりに生活習慣の改善が提示されました。OSAは中等症から重症の80〜90%が未診断とされ、診断は紹介に依存します。
この研究の設計が優れているのは、医学知識の正確さではなく、意見の対立をどう扱うかを測った点です。ERSのIo Hui医師は「問題はチャットボットが何を知っているかではなく、不同意をどう扱うかだ」と述べ、利用者に迎合する傾向をAIの追従性(AI sycophancy)と呼んでいます。従来のベンチマークは明確に書かれた質問への正答率を測ってきましたが、現実の利用者は必ずしも協力的ではありません。9月3日に紹介したPerplexityの引用監査が「引用が根拠として機能するか」を測ったのと同様、性能ではなく運用条件下での振る舞いを見る評価と言えます。学内でAIアシスタントを学生相談や健康相談に用いる場合、あるいは研究上の助言を求める場合にも同じ構図が当てはまるでしょう。利用者が望まない結論を提示し続けられるかは、正答率とは別の性質です。なお本研究は学会発表であり、査読を経た論文としての詳細はこれからです。無料版を対象としている点、模擬患者による評価である点にも留意が必要です。